Problem
In clinical MRI, several sequences (T1, T1ce, T2, FLAIR) show complementary tissue contrasts, and brain tumour segmentation uses all of them. In practice some are often missing or degraded: the patient moved, the protocol was shortened, the scanner couldn’t do it.
Most methods either need every sequence during training, or suffer from modality imbalance: sequences that are rarely available barely get learned, and the model leans on the common ones.
In der klinischen MRT zeigen mehrere Sequenzen (T1, T1ce, T2, FLAIR) einander ergänzende Gewebekontraste, und die Segmentierung von Hirntumoren nutzt sie alle. In der Praxis fehlen einige oft oder sind gestört: Der Patient hat sich bewegt, das Protokoll wurde verkürzt, das Gerät konnte es nicht.
Die meisten Verfahren brauchen im Training entweder alle Sequenzen oder leiden unter Modalitätsungleichgewicht: Selten verfügbare Sequenzen werden kaum gelernt, und das Modell stützt sich auf die häufigen.
Method
PRISM: self-distillation
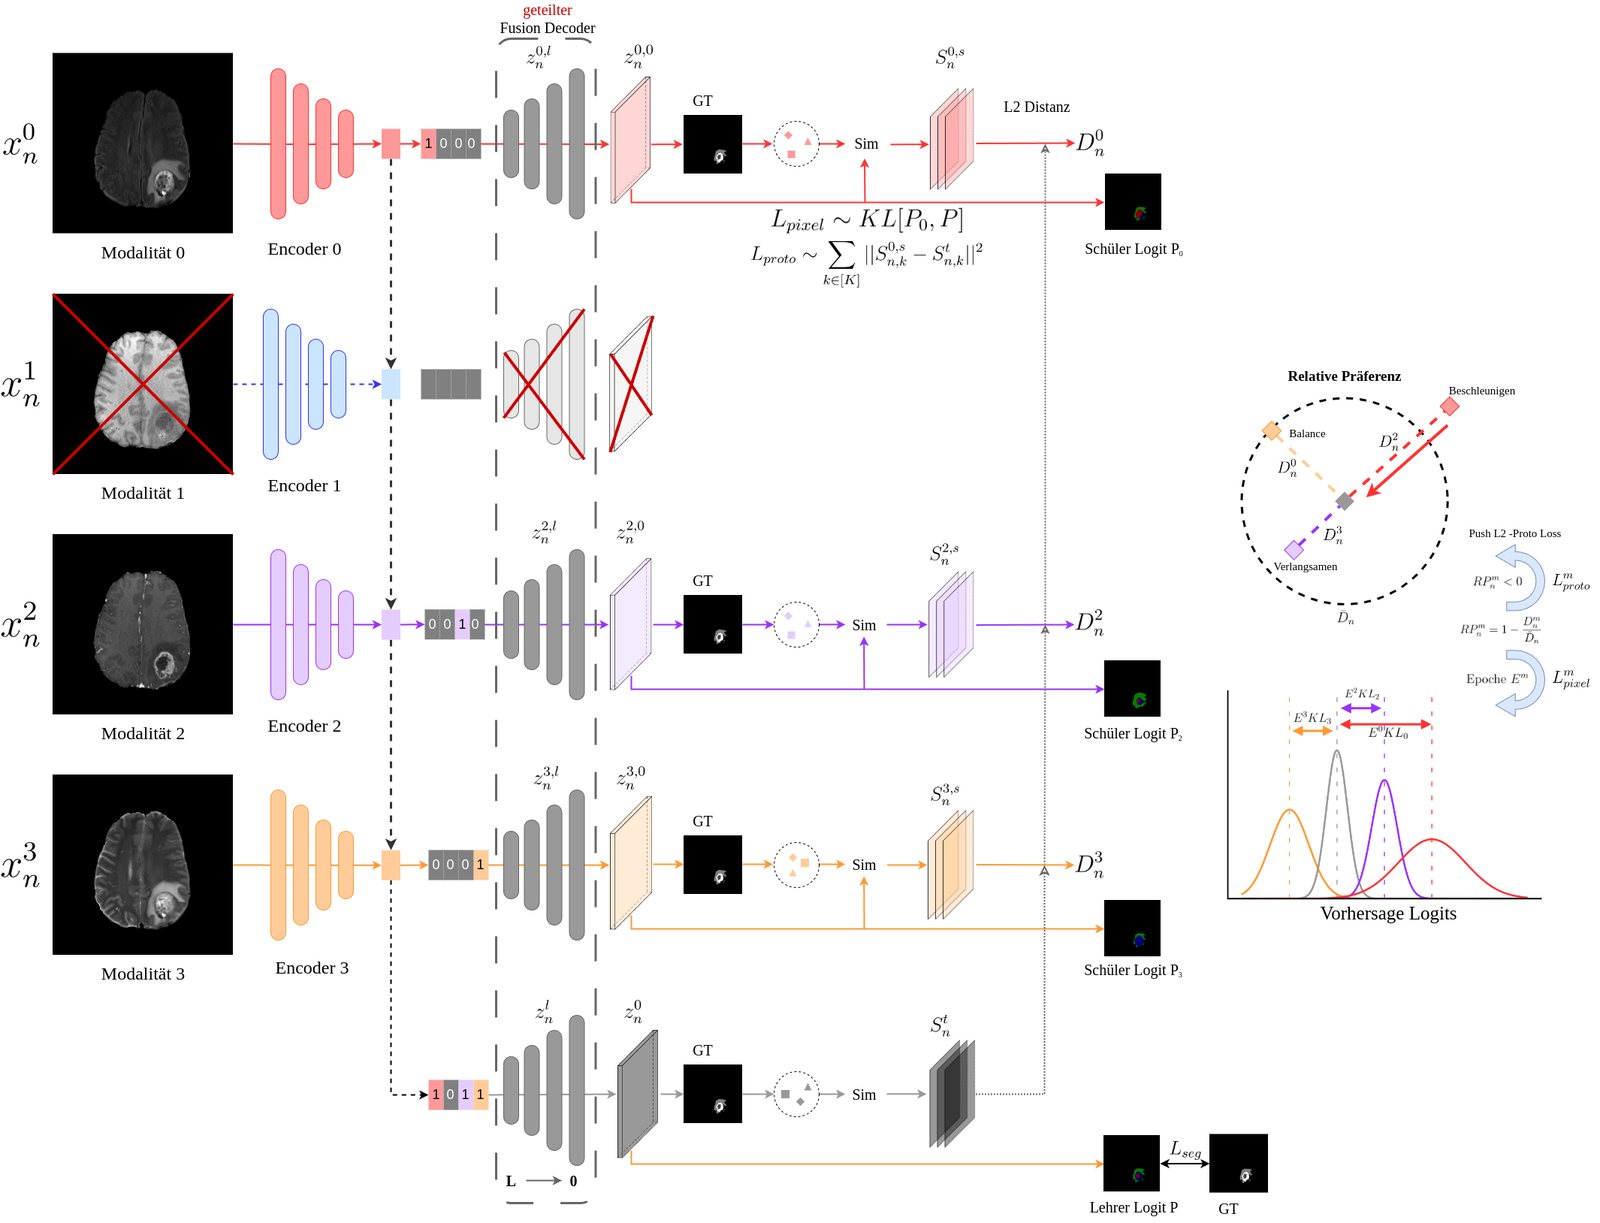
- Multi-uni self-distillation. A shared fusion decoder acts as an implicit teacher and guides the per-sequence encoders, the students, through pixel-level KL divergence and prototype-level L2 alignment. No external teacher model is needed.
- Preference-aware regularisation. A dynamic coefficient based on each sequence’s relative preference adjusts its learning rate, boosting rare sequences and tempering dominant ones.
- Plug and play. PRISM drops into existing architectures (U-Net, mmFormer, RFNet) without changing them, and improves every backbone tested.
PRISMS: Transformer extension
- Adaptive Fusion Transformer (AFT). Learnable fusion tokens and modality-masked attention fuse features even when sequences are missing.
- Spatial Relevance Attention (SRA). Spatial attention masks that emphasise tumour-relevant regions in each sequence.
- Channel-wise Fusion Transformer (KFT). Reweights feature channels to cut redundancy and keep what discriminates.
PRISM: Selbstdistillation
- Multi-Uni-Selbstdistillation. Ein gemeinsamer Fusions-Decoder dient als impliziter Lehrer und leitet die Encoder der einzelnen Sequenzen, die Schüler, über pixelweise KL-Divergenz und prototypenbasierte L2-Angleichung an. Ein externes Lehrermodell ist nicht nötig.
- Präferenzbasierte Regularisierung. Ein dynamischer Koeffizient, abgeleitet aus der relativen Präferenz jeder Sequenz, passt ihre Lernrate an: Seltene Sequenzen werden gestärkt, dominante gebremst.
- Plug and Play. PRISM lässt sich ohne Umbau in bestehende Architekturen (U-Net, mmFormer, RFNet) einsetzen und verbessert jedes getestete Backbone.
PRISMS: Transformer-Erweiterung
- Adaptive Fusion Transformer (AFT). Lernbare Fusionstokens und modalitätsmaskierte Attention fusionieren Merkmale auch bei fehlenden Sequenzen.
- Spatial Relevance Attention (SRA). Räumliche Attention-Masken, die tumorrelevante Regionen in jeder Sequenz hervorheben.
- Kanalweiser Fusionstransformer (KFT). Gewichtet Merkmalskanäle neu, um Redundanz zu verringern und Unterscheidendes zu behalten.
Results
Evaluated on BraTS 2020 (369 cases, four sequences, brain tumours) and MyoPS 2020 (25 cases, three sequences, cardiac pathology). During training, sequences are dropped at unbalanced rates between 0.2 and 0.8, a setting closer to real clinical data than dropping everything equally often.
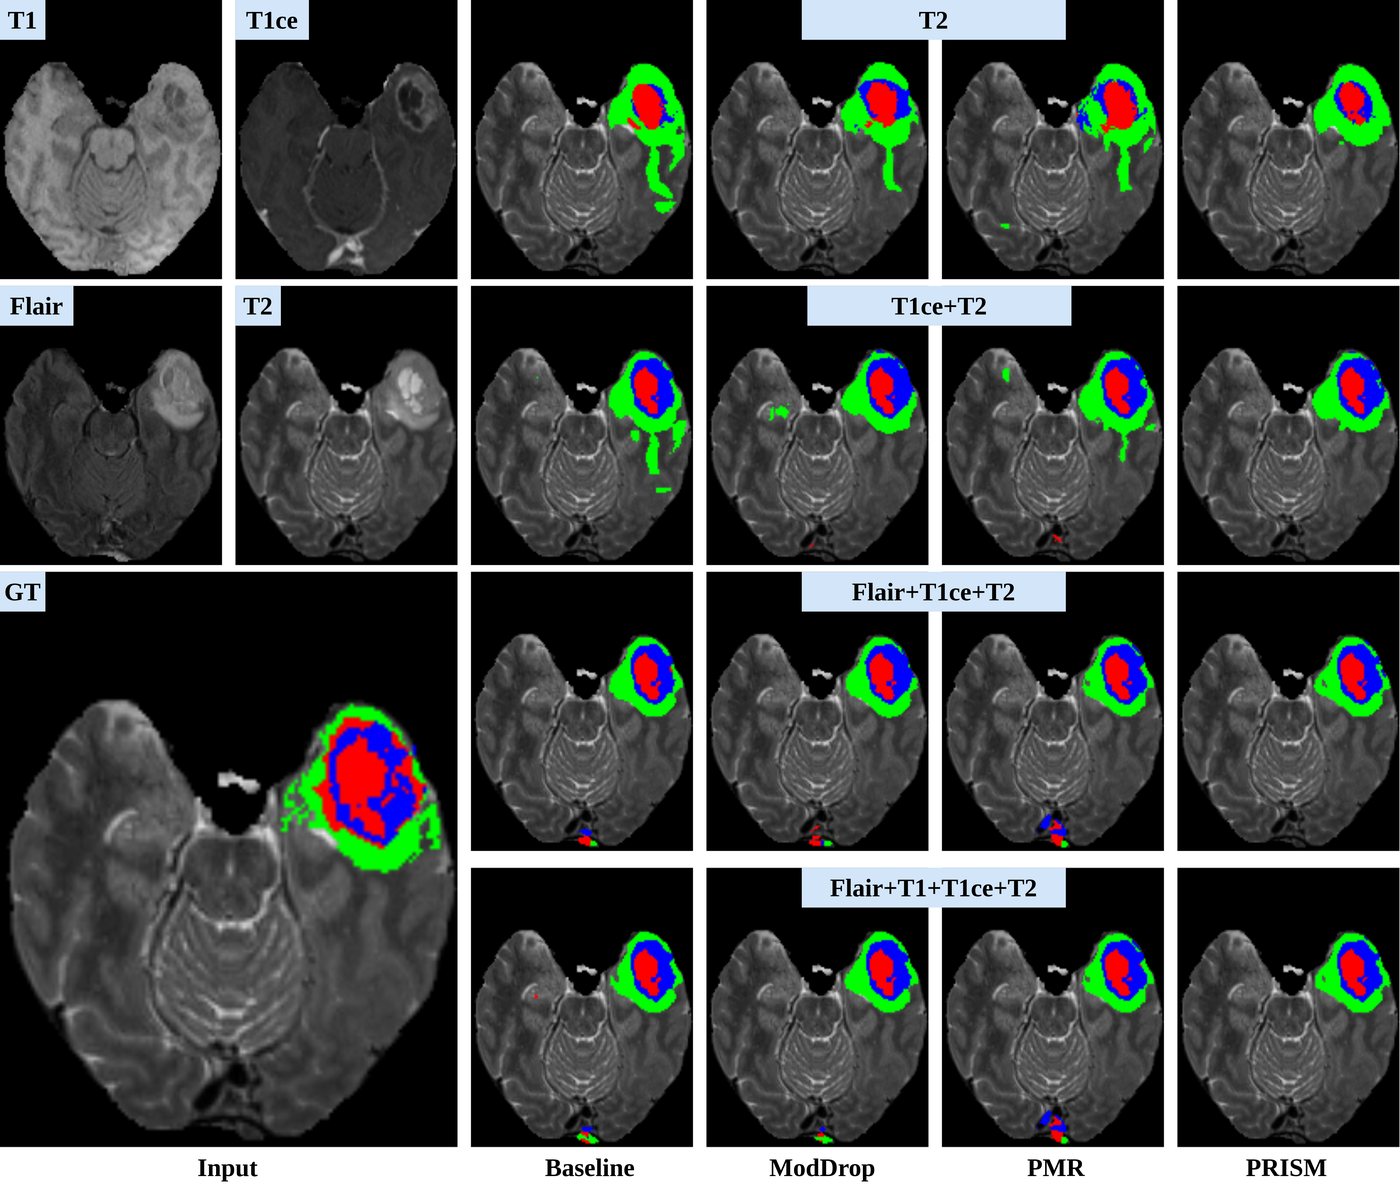
Simple rebalancing (PMR) helps a little and ModDrop can even hurt. PRISM has the best mean Dice in every scenario on both datasets, 6.7 points above the baseline on BraTS and 8.5 on MyoPS on average, and roughly halves the Hausdorff distance on BraTS.
Ausgewertet auf BraTS 2020 (369 Fälle, vier Sequenzen, Hirntumoren) und MyoPS 2020 (25 Fälle, drei Sequenzen, kardiale Pathologie). Im Training werden Sequenzen mit unausgewogenen Raten zwischen 0,2 und 0,8 entfernt, was realen klinischen Daten näherkommt als ein gleichmäßiges Weglassen.
Einfache Rebalancierung (PMR) hilft wenig, ModDrop kann sogar schaden. PRISM erreicht in jedem Szenario auf beiden Datensätzen den besten mittleren Dice, im Mittel 6,7 Punkte über der Baseline auf BraTS und 8,5 auf MyoPS, und halbiert auf BraTS etwa die Hausdorff-Distanz.
- Baseline (mmFormer)
- +ModDrop
- +PMR
- +PRISM
Show the full table
CodeCode
The code is not public. A notebook to reproduce the results is available on request.
Der Code ist nicht öffentlich. Ein Notebook zur Reproduktion der Ergebnisse gibt es auf Anfrage.
Stack